Domain steigerungsrate.de kaufen?
Wir ziehen mit dem Projekt
steigerungsrate.de um.
Sind Sie am Kauf der Domain
steigerungsrate.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain steigerungsrate.de kaufen?
Was ist eine Diskriminanzfunktion und wie wird sie in der Statistik zur Klassifizierung von Daten verwendet?
Eine Diskriminanzfunktion ist eine mathematische Funktion, die verwendet wird, um zwischen verschiedenen Klassen von Daten zu unterscheiden. Sie basiert auf statistischen Methoden wie der linearen Diskriminanzanalyse oder der quadratischen Diskriminanzanalyse. Die Diskriminanzfunktion wird verwendet, um neue Datenpunkte in die entsprechende Klasse zu klassifizieren, basierend auf den Merkmalen, die in der Funktion berücksichtigt werden. **
Was sind die wichtigsten Methoden zur Klassifizierung von Daten?
Die wichtigsten Methoden zur Klassifizierung von Daten sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning ungelabelte Daten verwendet, um Muster zu identifizieren. Semi-Supervised Learning kombiniert beide Ansätze und nutzt eine Mischung aus gelabelten und ungelabelten Daten für das Training von Modellen. **
Ähnliche Suchbegriffe für Klassifizierung
Top-Angebote
Produkte zum Begriff Klassifizierung:
-
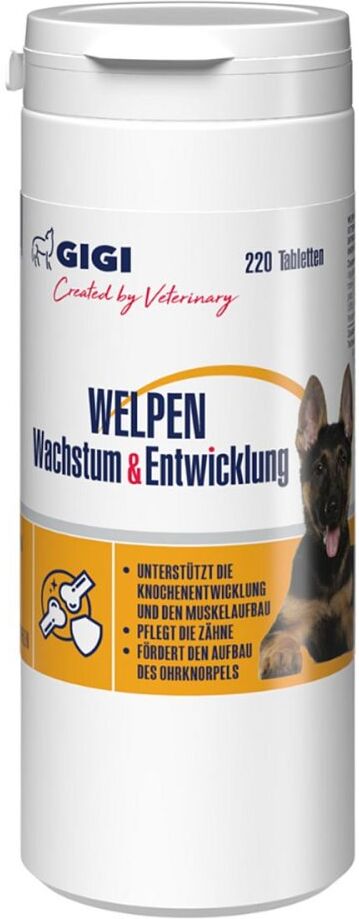
GIGI VET Welpen Wachstum & Entwicklung N220Anwendungsgebiet von GIGI VET Welpen Wachstum & Entwicklung N220 GIGI VET Welpen Wachstum & Entwicklung N220Für einen gesunden Start ins Leben:GIGI VET Welpen Wachstum & Entwicklung N220 – unsere speziell für Welpen ab der 4. Lebenswoche entwickelte Rezeptur unterstützt gezielt das Wachstum, die Knochenbildung und die Entwicklung des Immunsystems. Optimal abgestimmte Zusammensetzung:Hochwertige Vitamine, Mineralstoffe und AminosäurenMit Vitamin D3, Calcium und Phosphor für gesunde KnochenIdeal für wachsende Hunde in der sensiblen Entwicklungsphase. Ihre Vorteile auf einen Blick:Fördert ein stabiles Knochen- und GelenkgerüstStärkt das ImmunsystemUnterstützt Zellregeneration und VitalitätOhne künstliche Aromen oder KonservierungsstoffeVon Tierärzten entwickelt und empfohlenWirkungsweise von GIGI VET Welpen Wachstum & Entwicklung N220 Vitamin D3:Unterstützt die Aufnahme von Calcium aus der Nahrung und trägt dazu bei, dass es dem Knochenstoffwechsel zur Verfügung steht. Calcium:Ein wesentlicher Bestandteil von Knochen und Zähnen. Außerdem spielt es eine Rolle bei Muskelkontraktionen, der Herzfunktion und der Signalweiterleitung im Nervensystem. Ein ausgewogenes Calcium-Phosphor-Verhältnis ist dabei wichtig. Phosphor:Beteiligt an der Struktur von Knochen und Zellen und an verschiedenen Stoffwechselprozessen. Zusammen mit Calcium trägt es zu einer ausgewogenen Mineralisierung des Skeletts bei.Wirkstoffe / Inhaltsstoffe / ZutatenInhaltsstoffe von GIGI VET Welpen Wachstum & Entwicklung N220:Grätenmehl (10.4.5) – 39,9 %Dextrose (13.2.2) – 38,3 %Calciumhydrogenorthophosphat (11.3.1) – 18,1 %Magnesiumstearat (11.2.10) – 0,8 %Hefen, Mineralstoffe, Zucker, Öle und Fette – (keine Angabe)Analytische BestandteileRohasche 24 %, Rohprotein 7 %, Rohfaser 2 %, Rohöl und -fett 2 %, Calcium 13,6 %, Phosphor 7 %, Magnesium 0,5 %, Ölsäure 0,1 %.Zusatzstoffe pro kgTechnologische Zusatzstoffe: Mikrokristalline Cellulose27,16 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
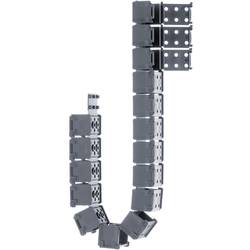
igus E1.17.044.028.0 Energieführungskette UL94-V2 Klassifizierung, Einfaches einlegen von KabelnModulares, einteiliges Band, aufklappbar im Außenradius. Einfach auf Länge zu kürzen und beliebig zu verlängern. Einfache Befestigung am Untergrund.5,49 €*Versand: 4,95 €Sichere Weiterleitung zum Anbieter
-
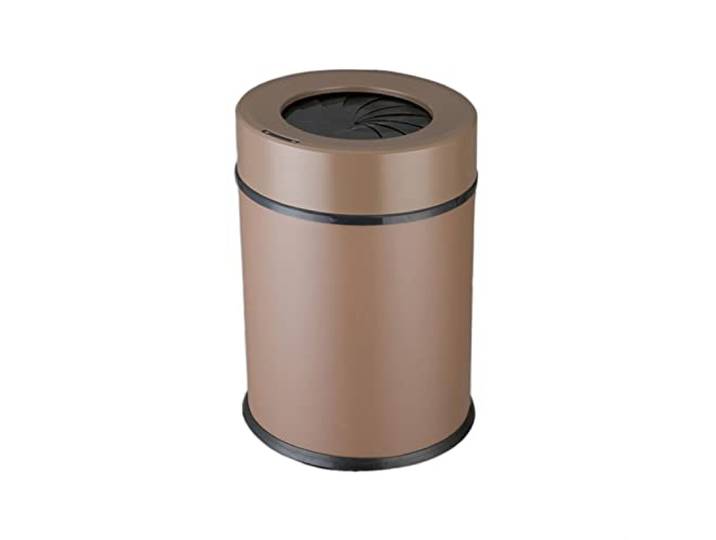
CVJdfhRE Abfalleimer, 6L/9L/13L Haushaltsmülleimer Badezimmer Wohnzimmer Klassifizierung(Bruin,9L)CVJdfhRE Abfalleimer, 6L/9L/13L Haushaltsmülleimer Badezimmer Wohnzimmer Klassifizierung(Bruin,9L). Öffnen und Schließen, passend for Sie, die es lieben. Wir verwenden Materialien und Technologien, damit unsere Produkte in rauen Umgebungen wie Ihrem Zuhause jahrelang halten. Fingerabdruckresistent, schmutzabweisend, Außenseite aus Edelstahl Seine Größe und sein Stil ermöglichen den Einsatz in vielen Bereichen Ihres Zuhauses Dieser Abfalleimer mit Deckel hilft dabei, Gerüche wirksam einzudämmen, und eignet sich daher ideal für den Einsatz in Badezimmern und Toiletten. Farbe:Bruin263,51 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Fahrmeir, Ludwig: StatistikStatistik , Der Weg zur Datenanalyse , Blattfeder > Sportfederung , Auflage: 9., überarb. und ergänzte Auflage 2023, Erscheinungsjahr: 20240311, Produktform: Kartoniert, Inhalt/Anzahl: 1, Inhalt/Anzahl: 1, Beilage: Book + Digital Flashcards, Titel der Reihe: Springer-Lehrbuch##, Autoren: Fahrmeir, Ludwig~Heumann, Christian~Künstler, Rita~Pigeot, Iris~Tutz, Gerhard, Auflage: 23009, Auflage/Ausgabe: 9., überarb. und ergänzte Auflage 2023, Abbildungen: XIV, 656 S. 239 Abbildungen, 8 Abbildungen in Farbe., Themenüberschrift: MATHEMATICS / Probability & Statistics / General, Keyword: Datenanalyse mit R;Parameterschätzung;Regressionsanalyse;Statistik;Varianz;Varianzanalyse;Wahrscheinlichkeit;Wahrscheinlichkeitsrechnung;Zeitreihen;Zufallsvariable;Zufallsvariablen, Fachschema: Mathematik / Statistik~Ökonometrie~Statistik~Stochastik~Wahrscheinlichkeitsrechnung~Statistik / Wirtschaftsstatistik~Wirtschaftsstatistik~Wirtschaftstheorie~Wirtschaft / Allgemeines, Einführung, Lexikon, Fachkategorie: Wirtschaftswissenschaft, Imprint-Titels: Springer Spektrum, Warengruppe: HC/Volkswirtschaft, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Sender’s product category: BUNDLE, Länge: 238, Breite: 168, Höhe: 30, Gewicht: 1028, Produktform: Kartoniert, Genre: Sozialwissenschaften/Recht/Wirtschaft,49,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Was sind die verschiedenen Methoden zur Klassifizierung von Objekten oder Daten?
Die verschiedenen Methoden zur Klassifizierung von Objekten oder Daten umfassen Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Beim Supervised Learning werden Trainingsdaten mit bekannten Labels verwendet, um ein Modell zu trainieren. Beim Unsupervised Learning werden keine Labels verwendet, das Modell identifiziert automatisch Muster und Gruppierungen in den Daten. Beim Semi-Supervised Learning werden sowohl gelabelte als auch ungelabelte Daten verwendet, um ein Modell zu trainieren. **
-
Was sind die gängigen Methoden zur Klassifizierung von Objekten oder Daten?
Die gängigen Methoden zur Klassifizierung von Objekten oder Daten sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um ein Modell zu trainieren, das dann neue Daten klassifizieren kann. Unsupervised Learning gruppiert Daten basierend auf Ähnlichkeiten, ohne dass gelabelte Daten benötigt werden. Semi-Supervised Learning kombiniert Elemente von Supervised und Unsupervised Learning, indem es sowohl gelabelte als auch ungelabelte Daten verwendet. **
-
Wie werden Objekte in der Klassifizierung entsprechend ihrer Eigenschaften und Merkmale eingeordnet? Was sind die Kriterien für eine erfolgreiche Klassifizierung von Daten?
Objekte werden in der Klassifizierung basierend auf ihren gemeinsamen Eigenschaften und Merkmalen gruppiert. Die Kriterien für eine erfolgreiche Klassifizierung von Daten sind die Genauigkeit der Zuordnung, die Konsistenz der Kategorisierung und die Relevanz der Merkmale für die Gruppierung. Eine klare Definition der Kategorien und eine sorgfältige Analyse der Daten sind entscheidend für eine effektive Klassifizierung. **
-
"Warum ist es wichtig, Produkte und Informationen entsprechend ihrer Klassifizierung zu organisieren?" "Was sind die Vorteile einer effektiven Klassifizierung von Daten und Objekten?"
Eine effektive Klassifizierung von Produkten und Informationen erleichtert die Suche und den Zugriff auf relevante Daten. Sie ermöglicht eine schnellere Entscheidungsfindung und verbessert die Effizienz von Arbeitsprozessen. Zudem trägt sie dazu bei, die Sicherheit und den Schutz sensibler Informationen zu gewährleisten. **

Was sind die gängigsten Methoden zur Klassifizierung von Daten in der Informatik?
Die gängigsten Methoden zur Klassifizierung von Daten in der Informatik sind die Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Muster zu erkennen und Vorhersagen zu treffen. Unsupervised Learning findet Muster in unlabeled Daten, während Semi-Supervised Learning eine Kombination aus beidem ist. **
Was sind die verschiedenen Methoden zur Klassifizierung von Daten in der Informatik?
Die verschiedenen Methoden zur Klassifizierung von Daten in der Informatik sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Beim Supervised Learning werden Daten mit bereits bekannten Labels trainiert, beim Unsupervised Learning werden Muster und Strukturen in den Daten identifiziert, und beim Semi-Supervised Learning werden sowohl gelabelte als auch ungelabelte Daten verwendet. Jede Methode hat ihre eigenen Vor- und Nachteile und wird je nach Anwendungsfall ausgewählt. **
Top-Angebote
Produkte zum Begriff Klassifizierung:
-
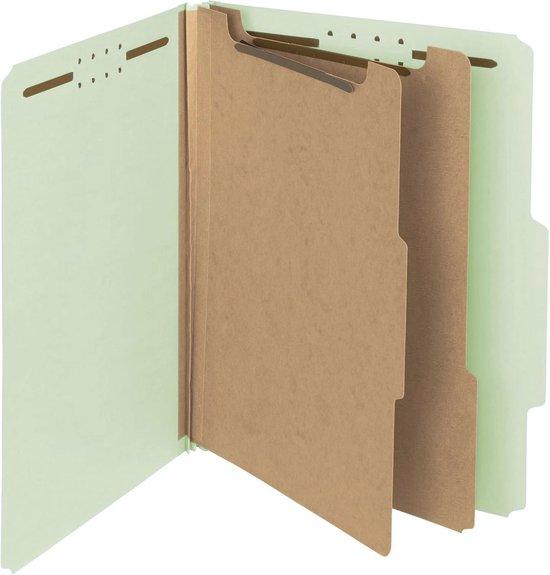
Recycelte Kommode Klassifizierung Ordner mit 3 DilerDiese Karte für die Klassifizierung von Recycling-Kommode ist perfekt für das umweltbewusste Büro. Geeignet für Personal, Immobilien, Buchhaltung oder Bankdateien. Aus massiver 25 pt Pressboard, mit 2" Befestigungselementen auf den Bezügen und 1" auf den Verteilern. Die starken und langlebigen Tyvek Kreuze sorgen für zusätzliche Stärke. Die 20 pt Kraft Verteiler sind voll an den Kreuzen befestigt. Dieser Ordner hat eine Top-Registerkarte und ist in der Größe Brief mit 3 Abschnitten. Farbe: Grau/grün.372,98 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
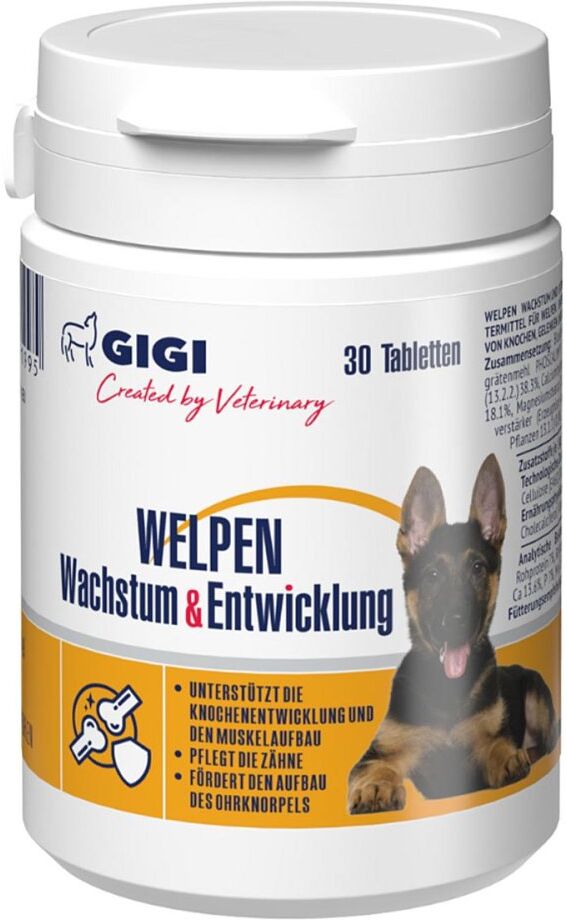
GIGI VET Welpen Wachstum & Entwicklung N30Anwendungsgebiet von GIGI VET Welpen Wachstum & Entwicklung N30 GIGI VET Welpen Wachstum & Entwicklung N30Für einen gesunden Start ins Leben:GIGI VET Welpen Wachstum & Entwicklung N30 – unsere speziell für Welpen ab der 4. Lebenswoche entwickelte Rezeptur unterstützt gezielt das Wachstum, die Knochenbildung und die Entwicklung des Immunsystems. Optimal abgestimmte Zusammensetzung:Hochwertige Vitamine, Mineralstoffe und AminosäurenMit Vitamin D3, Calcium und Phosphor für gesunde KnochenIdeal für wachsende Hunde in der sensiblen Entwicklungsphase. Ihre Vorteile auf einen Blick:Fördert ein stabiles Knochen- und GelenkgerüstStärkt das ImmunsystemUnterstützt Zellregeneration und VitalitätOhne künstliche Aromen oder KonservierungsstoffeVon Tierärzten entwickelt und empfohlenWirkungsweise von GIGI VET Welpen Wachstum & Entwicklung N30 Vitamin D3:Unterstützt die Aufnahme von Calcium aus der Nahrung und trägt dazu bei, dass es dem Knochenstoffwechsel zur Verfügung steht. Calcium:Ein wesentlicher Bestandteil von Knochen und Zähnen. Außerdem spielt es eine Rolle bei Muskelkontraktionen, der Herzfunktion und der Signalweiterleitung im Nervensystem. Ein ausgewogenes Calcium-Phosphor-Verhältnis ist dabei wichtig. Phosphor:Beteiligt an der Struktur von Knochen und Zellen und an verschiedenen Stoffwechselprozessen. Zusammen mit Calcium trägt es zu einer ausgewogenen Mineralisierung des Skeletts bei.Wirkstoffe / Inhaltsstoffe / ZutatenInhaltsstoffe von GIGI VET Welpen Wachstum & Entwicklung N30:Grätenmehl (10.4.5) – 39,9 %Dextrose (13.2.2) – 38,3 %Calciumhydrogenorthophosphat (11.3.1) – 18,1 %Magnesiumstearat (11.2.10) – 0,8 %Hefen, Mineralstoffe, Zucker, Öle und Fette – (keine Angabe)Analytische BestandteileRohasche 24 %, Rohprotein 7 %, Rohfaser 2 %, Rohöl und -fett 2 %, Calcium 13,6 %, Phosphor 7 %, Magnesium 0,5 %, Ölsäure 0,1 %.Zusatzstoffe pro kgTechnologische Zusatzstoffe: Mikrokristalline Cellulose 20 g6,86 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
GIGI VET Welpen Wachstum & Entwicklung N220Anwendungsgebiet von GIGI VET Welpen Wachstum & Entwicklung N220 GIGI VET Welpen Wachstum & Entwicklung N220Für einen gesunden Start ins Leben:GIGI VET Welpen Wachstum & Entwicklung N220 – unsere speziell für Welpen ab der 4. Lebenswoche entwickelte Rezeptur unterstützt gezielt das Wachstum, die Knochenbildung und die Entwicklung des Immunsystems. Optimal abgestimmte Zusammensetzung:Hochwertige Vitamine, Mineralstoffe und AminosäurenMit Vitamin D3, Calcium und Phosphor für gesunde KnochenIdeal für wachsende Hunde in der sensiblen Entwicklungsphase. Ihre Vorteile auf einen Blick:Fördert ein stabiles Knochen- und GelenkgerüstStärkt das ImmunsystemUnterstützt Zellregeneration und VitalitätOhne künstliche Aromen oder KonservierungsstoffeVon Tierärzten entwickelt und empfohlenWirkungsweise von GIGI VET Welpen Wachstum & Entwicklung N220 Vitamin D3:Unterstützt die Aufnahme von Calcium aus der Nahrung und trägt dazu bei, dass es dem Knochenstoffwechsel zur Verfügung steht. Calcium:Ein wesentlicher Bestandteil von Knochen und Zähnen. Außerdem spielt es eine Rolle bei Muskelkontraktionen, der Herzfunktion und der Signalweiterleitung im Nervensystem. Ein ausgewogenes Calcium-Phosphor-Verhältnis ist dabei wichtig. Phosphor:Beteiligt an der Struktur von Knochen und Zellen und an verschiedenen Stoffwechselprozessen. Zusammen mit Calcium trägt es zu einer ausgewogenen Mineralisierung des Skeletts bei.Wirkstoffe / Inhaltsstoffe / ZutatenInhaltsstoffe von GIGI VET Welpen Wachstum & Entwicklung N220:Grätenmehl (10.4.5) – 39,9 %Dextrose (13.2.2) – 38,3 %Calciumhydrogenorthophosphat (11.3.1) – 18,1 %Magnesiumstearat (11.2.10) – 0,8 %Hefen, Mineralstoffe, Zucker, Öle und Fette – (keine Angabe)Analytische BestandteileRohasche 24 %, Rohprotein 7 %, Rohfaser 2 %, Rohöl und -fett 2 %, Calcium 13,6 %, Phosphor 7 %, Magnesium 0,5 %, Ölsäure 0,1 %.Zusatzstoffe pro kgTechnologische Zusatzstoffe: Mikrokristalline Cellulose27,16 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
igus E1.17.044.028.0 Energieführungskette UL94-V2 Klassifizierung, Einfaches einlegen von KabelnModulares, einteiliges Band, aufklappbar im Außenradius. Einfach auf Länge zu kürzen und beliebig zu verlängern. Einfache Befestigung am Untergrund.5,49 €*Versand: 4,95 €Sichere Weiterleitung zum Anbieter
-
Was ist eine Diskriminanzfunktion und wie wird sie in der Statistik zur Klassifizierung von Daten verwendet?
Eine Diskriminanzfunktion ist eine mathematische Funktion, die verwendet wird, um zwischen verschiedenen Klassen von Daten zu unterscheiden. Sie basiert auf statistischen Methoden wie der linearen Diskriminanzanalyse oder der quadratischen Diskriminanzanalyse. Die Diskriminanzfunktion wird verwendet, um neue Datenpunkte in die entsprechende Klasse zu klassifizieren, basierend auf den Merkmalen, die in der Funktion berücksichtigt werden. **
-
Was sind die wichtigsten Methoden zur Klassifizierung von Daten?
Die wichtigsten Methoden zur Klassifizierung von Daten sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Modelle zu trainieren, während Unsupervised Learning ungelabelte Daten verwendet, um Muster zu identifizieren. Semi-Supervised Learning kombiniert beide Ansätze und nutzt eine Mischung aus gelabelten und ungelabelten Daten für das Training von Modellen. **
-
Was sind die verschiedenen Methoden zur Klassifizierung von Objekten oder Daten?
Die verschiedenen Methoden zur Klassifizierung von Objekten oder Daten umfassen Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Beim Supervised Learning werden Trainingsdaten mit bekannten Labels verwendet, um ein Modell zu trainieren. Beim Unsupervised Learning werden keine Labels verwendet, das Modell identifiziert automatisch Muster und Gruppierungen in den Daten. Beim Semi-Supervised Learning werden sowohl gelabelte als auch ungelabelte Daten verwendet, um ein Modell zu trainieren. **
-
Was sind die gängigen Methoden zur Klassifizierung von Objekten oder Daten?
Die gängigen Methoden zur Klassifizierung von Objekten oder Daten sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um ein Modell zu trainieren, das dann neue Daten klassifizieren kann. Unsupervised Learning gruppiert Daten basierend auf Ähnlichkeiten, ohne dass gelabelte Daten benötigt werden. Semi-Supervised Learning kombiniert Elemente von Supervised und Unsupervised Learning, indem es sowohl gelabelte als auch ungelabelte Daten verwendet. **
Ähnliche Suchbegriffe für Klassifizierung
-
CVJdfhRE Abfalleimer, 6L/9L/13L Haushaltsmülleimer Badezimmer Wohnzimmer Klassifizierung(Bruin,9L)CVJdfhRE Abfalleimer, 6L/9L/13L Haushaltsmülleimer Badezimmer Wohnzimmer Klassifizierung(Bruin,9L). Öffnen und Schließen, passend for Sie, die es lieben. Wir verwenden Materialien und Technologien, damit unsere Produkte in rauen Umgebungen wie Ihrem Zuhause jahrelang halten. Fingerabdruckresistent, schmutzabweisend, Außenseite aus Edelstahl Seine Größe und sein Stil ermöglichen den Einsatz in vielen Bereichen Ihres Zuhauses Dieser Abfalleimer mit Deckel hilft dabei, Gerüche wirksam einzudämmen, und eignet sich daher ideal für den Einsatz in Badezimmern und Toiletten. Farbe:Bruin263,51 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Fahrmeir, Ludwig: StatistikStatistik , Der Weg zur Datenanalyse , Blattfeder > Sportfederung , Auflage: 9., überarb. und ergänzte Auflage 2023, Erscheinungsjahr: 20240311, Produktform: Kartoniert, Inhalt/Anzahl: 1, Inhalt/Anzahl: 1, Beilage: Book + Digital Flashcards, Titel der Reihe: Springer-Lehrbuch##, Autoren: Fahrmeir, Ludwig~Heumann, Christian~Künstler, Rita~Pigeot, Iris~Tutz, Gerhard, Auflage: 23009, Auflage/Ausgabe: 9., überarb. und ergänzte Auflage 2023, Abbildungen: XIV, 656 S. 239 Abbildungen, 8 Abbildungen in Farbe., Themenüberschrift: MATHEMATICS / Probability & Statistics / General, Keyword: Datenanalyse mit R;Parameterschätzung;Regressionsanalyse;Statistik;Varianz;Varianzanalyse;Wahrscheinlichkeit;Wahrscheinlichkeitsrechnung;Zeitreihen;Zufallsvariable;Zufallsvariablen, Fachschema: Mathematik / Statistik~Ökonometrie~Statistik~Stochastik~Wahrscheinlichkeitsrechnung~Statistik / Wirtschaftsstatistik~Wirtschaftsstatistik~Wirtschaftstheorie~Wirtschaft / Allgemeines, Einführung, Lexikon, Fachkategorie: Wirtschaftswissenschaft, Imprint-Titels: Springer Spektrum, Warengruppe: HC/Volkswirtschaft, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Sender’s product category: BUNDLE, Länge: 238, Breite: 168, Höhe: 30, Gewicht: 1028, Produktform: Kartoniert, Genre: Sozialwissenschaften/Recht/Wirtschaft,49,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Bamberg, Günter: StatistikStatistik , Eine Einführung für Wirtschafts- und Sozialwissenschaftler , Erste-Hilfe-Ausrüstung > Sicherheit , Auflage: 19., überarbeitete Auflage, Erscheinungsjahr: 20220523, Produktform: Kartoniert, Titel der Reihe: De Gruyter Studium##, Autoren: Bamberg, Günter~Baur, Franz~Krapp, Michael, Auflage: 22019, Auflage/Ausgabe: 19., überarbeitete Auflage, Seitenzahl/Blattzahl: 322, Themenüberschrift: BUSINESS & ECONOMICS / Statistics, Keyword: Deskriptive Statistik; Wahrscheinlichkeitsrechnung; Verteilungen; Induktive Statistik; Signifikanztest; Zeitreihen, Fachschema: Ökonometrie~Statistik / Wirtschaftsstatistik~Wirtschaftsstatistik, Fachkategorie: Betriebswirtschaft und Management, Bildungszweck: für die Hochschule, Warengruppe: HC/Betriebswirtschaft, Fachkategorie: Ökonometrie und Wirtschaftsstatistik, Thema: Verstehen, Text Sprache: ger, Seitenanzahl: X, Seitenanzahl: 322, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: de Gruyter Oldenbourg, Verlag: de Gruyter Oldenbourg, Verlag: De Gruyter Oldenbourg, Länge: 238, Breite: 170, Höhe: 19, Gewicht: 566, Produktform: Kartoniert, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, Vorgänger: 2159554, Vorgänger EAN: 9783110495706 9783486716511 9783486702583 9783486590883 9783486585650, Alternatives Format EAN: 9783110759402 9783110759327, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0060, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 162715929,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
igus E1.20.015.028.0 Energieführungskette UL94-V2 Klassifizierung, Einfaches einlegen von KabelnModulares, einteiliges Band, aufklappbar im Außenradius. Einfach auf Länge zu kürzen und beliebig zu verlängern. Einfache Befestigung am Untergrund.11,99 €*Versand: 4,95 €Sichere Weiterleitung zum Anbieter
-
Wie werden Objekte in der Klassifizierung entsprechend ihrer Eigenschaften und Merkmale eingeordnet? Was sind die Kriterien für eine erfolgreiche Klassifizierung von Daten?
Objekte werden in der Klassifizierung basierend auf ihren gemeinsamen Eigenschaften und Merkmalen gruppiert. Die Kriterien für eine erfolgreiche Klassifizierung von Daten sind die Genauigkeit der Zuordnung, die Konsistenz der Kategorisierung und die Relevanz der Merkmale für die Gruppierung. Eine klare Definition der Kategorien und eine sorgfältige Analyse der Daten sind entscheidend für eine effektive Klassifizierung. **
-
"Warum ist es wichtig, Produkte und Informationen entsprechend ihrer Klassifizierung zu organisieren?" "Was sind die Vorteile einer effektiven Klassifizierung von Daten und Objekten?"
Eine effektive Klassifizierung von Produkten und Informationen erleichtert die Suche und den Zugriff auf relevante Daten. Sie ermöglicht eine schnellere Entscheidungsfindung und verbessert die Effizienz von Arbeitsprozessen. Zudem trägt sie dazu bei, die Sicherheit und den Schutz sensibler Informationen zu gewährleisten. **
-
Was sind die gängigsten Methoden zur Klassifizierung von Daten in der Informatik?
Die gängigsten Methoden zur Klassifizierung von Daten in der Informatik sind die Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Supervised Learning verwendet gelabelte Daten, um Muster zu erkennen und Vorhersagen zu treffen. Unsupervised Learning findet Muster in unlabeled Daten, während Semi-Supervised Learning eine Kombination aus beidem ist. **
-
Was sind die verschiedenen Methoden zur Klassifizierung von Daten in der Informatik?
Die verschiedenen Methoden zur Klassifizierung von Daten in der Informatik sind Supervised Learning, Unsupervised Learning und Semi-Supervised Learning. Beim Supervised Learning werden Daten mit bereits bekannten Labels trainiert, beim Unsupervised Learning werden Muster und Strukturen in den Daten identifiziert, und beim Semi-Supervised Learning werden sowohl gelabelte als auch ungelabelte Daten verwendet. Jede Methode hat ihre eigenen Vor- und Nachteile und wird je nach Anwendungsfall ausgewählt. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.